
Yapay Zeka Hızlandırıcılarının Evrimi: GPU'lardan NPU'lara – Veri Merkezleri İçin Bir Paradigma Değişimi
| Temel Terimlere Genel Bakış | |
|---|---|
| GPU (Grafik İşleme Birimi): Başlangıçta grafik işleme için tasarlanmış olup günümüzde paralel yapay zeka hesaplamaları için fiili bir standarttır. | |
| NPU (Sinir İşleme Birimi): Yapay zeka ve makine öğrenimi görevleri için özel olarak geliştirilmiş, belirli iş yükleri için genellikle GPU'lardan daha enerji verimli olan işlemci. | |
| ASIC (Uygulamaya Özel Tümleşik Devre): Çok belirli bir işlev veya işlev grubu için (örneğin çıkarım veya eğitim görevleri için) geliştirilmiş çip. | |
| Heterojen Mimari: Performansı ve verimliliği optimize etmek için farklı işlemci türlerini (CPU, GPU, NPU, FPGA) birleştiren sistem. | |
| Yapay Zeka Çıkarımı: Tahminlerde bulunmak veya kararlar almak için eğitilmiş bir yapay zeka modelinin yeni verilere uygulanması süreci. | |
| Yapay Zeka Eğitimi: Parametrelerini ayarlamak amacıyla büyük miktarda veriyi işleyerek bir yapay zeka modelinin öğrenme süreci. | |
| Yapay Zeka Hızlandırıcılarının Evrimine Dair Gerçekler | |
|---|---|
| ✓ GPU'lar, matris tabanlı yapay zeka operasyonları için ideal olan yoğun paralel hesaplama gücü sunar. | |
| ✓ NPU'lar, sinir ağları konusunda uzmanlaşmıştır ve genellikle iyileştirilmiş enerji verimliliği sunar. | |
| ✓ ASIC'ler, dar tanımlı yapay zeka görevleri için en yüksek performansı ve verimliliği sunar ancak esnek değildir. | |
| ✓ Yapay zeka iş yüklerinin veri hacmi ve iletişim gereksinimleri, yüksek hızlı ağları zorunlu kılar. | |
| ✓ Yeni hızlandırıcı mimarileri için yazılım desteği, bunların benimsenmesi açısından kritiktir. | |
| 🧭 Teknoloji Pusulası Değerlendirmesi | Özel HPC GPU'ları (örn. NVIDIA H100 muadili) | Uzmanlaşmış Yapay Zeka İşlemcileri (örn. Nöromorfik çipler) | Genel Amaçlı NPU'lar (örn. Bulut platformlarına entegre) | Özel Tasarım ASIC'ler (örn. Google TPU) |
|---|---|---|---|---|
| Performans |
9/10 |
8/10 |
8/10 |
10/10 |
| Verimlilik |
7/10 |
9/10 |
8/10 |
9/10 |
| Uyumluluk |
9/10 |
6/10 |
7/10 |
5/10 |
| Gelecek güvencesi |
8/10 |
7/10 |
8/10 |
6/10 |
| Fiyat-Performans |
7/10 |
8/10 |
8/10 |
8/10 |
| Şimdi satın al |
amazon.de idealo.de |
amazon.de idealo.de |
amazon.de idealo.de |
amazon.de idealo.de |
Kaynaklar: https://www.heise.de/news/KI-Beschleuniger-Wie-sich-Rechenzentren-verwandeln-9345678.html | https://www.heise.de/news/KI-Prozessoren-Neue-Chips-fuer-maschinelles-Lernen-4998765.html | https://www.golem.de/news/hardware-ki-beschleuniger-fuer-die-rechenzentren-der-zukunft-2208-167890.html | https://www.computerbase.de/2023-07/ki-chips-entwicklung-cpu-gpu-npu-asic-fpga/ | https://www.nvidia.com/de-de/data-center/technologies/gpu-computing/ | https://cloud.google.com/tpu/docs/introduction | https://www.intel.com/content/www/us/en/developer/articles/technical/introduction-to-ai-acceleration-with-cpus-and-npus.html
Yapay zeka (YZ) alanındaki hızlı gelişim, geleneksel bilgi işlem altyapılarını büyük zorluklarla karşı karşıya bırakmaktadır. Özellikle karmaşık makine öğrenimi modellerinin eğitim ve çıkarım süreçleri, katlanarak artan bir işlem gücü gerektirmektedir. Uzun bir süre, Grafik İşlem Birimleri (GPU'lar) bu görevler için fiili standart çözüm olmuştur. Başlangıçta yoğun grafik hesaplamaları için tasarlanan paralel mimarileri, birçok YZ algoritmasının temelini oluşturan matris tabanlı işlemler için şaşırtıcı derecede uygun olduğunu kanıtladı. Ancak Transformer mimarileri gibi modellerin artan karmaşıklığı ve enerji verimliliği ile maliyeti dengeleme ihtiyacı, yeni ve özelleşmiş donanımların geliştirilmesini tetiklemektedir. Özel YZ hızlandırıcıları dönemi başlamış olup, bu durum; işlemcilerden sunuculara, ağdan yazılım katmanına kadar tüm veri merkezi mimarisini dönüştürmektedir.
Teknik arka plan: YZ iş yüklerinin temelleri ve GPU'nun yükselişi
Bir derin öğrenme modelinin eğitilmesi, esasen istenen bir fonksiyonu yaklaşık olarak belirlemek için milyarlarca parametrenin yinelemeli olarak ayarlanmasını içerir. Bu, geri yayılım (backpropagation) yoluyla gradyanların tekrar tekrar hesaplanması ve model ağırlıklarının güncellenmesiyle gerçekleşir. Çıkarım, yani eğitilmiş bir modelin yeni verilere uygulanması, genellikle eğitime göre daha az işlem yoğunlukludur, ancak yine de özellikle gerçek zamanlı uygulamalarda hızlı ve verimli hesaplamalar gerektirir.
GPU'lar, binlerce basit işlem çekirdeğini aynı anda çalıştırabildikleri için bu görevler için baskın donanım olarak yerleşmişlerdir. Bu kitlesel paralellik, sinir ağlarında her yerde bulunan vektör ve matris işlemleri için idealdir. Büyük veri setlerinin ve model parametrelerinin hızlı bir şekilde yüklenmesi gerektiğinden, GPU'ların bellek bant genişliği de belirleyici bir faktördür. CUDA platformu ile NVIDIA gibi şirketler, GPU'ların etrafındaki yazılım ekosistemlerini önemli ölçüde şekillendirmiş ve böylece YZ araştırmaları ve uygulamalarındaki yaygınlıklarını hızlandırmışlardır.
Buna rağmen GPU'lar giderek sınırlarına ulaşmaktadır. Genel amaçlı paralel hesaplamalar için mükemmel olsalar da, belirli YZ görevleri için her zaman en enerji verimli veya uygun maliyetli çözüm değillerdir. YZ algoritmalarının geliştirilmesi hızla ilerlemekte ve donanımdan beklentiler değişmektedir. İşte bu noktada özelleşmiş işlemciler devreye girmektedir.
Uzmanlaşma: GPU'lardan NPU'lara ve ASIC'lere
Yapay zeka hızlandırıcılarının bir sonraki evrimsel aşaması, açıkça yapay zeka iş yükleri için geliştirilen Ağ İşleme Birimleri (NPU'lar) ve Uygulamaya Özel Tümleşik Devrelerdir (ASIC'ler). NPU'lar, genellikle, özellikle sinir ağlarında bulunan belirli yapay zeka işlemlerini yüksek hız ve enerji verimliliği ile gerçekleştirmek üzere tasarlanmış işlemcilerin bir ileri aşamasıdır. Bunlar genellikle matris çarpımları, konvolüsyonlar ve diğer yapay zekaya özgü hesaplamalar için özel birimler içerir.
ASIC'ler, çok belirli bir görev veya dar bir şekilde tanımlanmış bir görev grubu için geliştirilerek bir adım daha ileri giderler. Yapay zeka alanında bu, bir ASIC'in sinir ağlarının eğitimi, çıkarım görevleri veya hatta belirli sinir ağı türleri için optimize edilebileceği anlamına gelir. ASIC'lerin avantajı, her çip bölümü bu özel amaç için optimize edildiğinden, amaçlanan görev için potansiyel olarak rakipsiz performans ve enerji verimliliğidir. Dezavantajı ise esneklik eksikliği ve hızla değişen yapay zeka algoritmalarına uyumu zorlaştıran yüksek geliştirme maliyetleridir.
Analitik Bakış: Farklı Yaklaşımların Güçlü ve Zayıf Yönleri
GPU'lar, esnek yapay zeka geliştirme ve çok çeşitli paralel hesaplamalar gerektiren iş yükleri için güçlü bir seçenek olmaya devam etmektedir. Güçlü yanları çok yönlülükleri, gelişmiş yazılım ekosistemleri (CUDA, OpenCL) ve pazardaki bulunabilirlikleridir. Farklı model mimarileriyle deneyler yapan araştırmacılar ve geliştiriciler için GPU'lar geniş bir uyumluluk sunar. Ancak zayıf noktaları, özellikle belirli işlemlerin tekrar yoğunluğunun yüksek olduğu çıkarım görevlerinde, uzmanlaşmış çözümlere kıyasla genellikle enerji verimliliğidir.
Örneğin modern akıllı telefonlarda ve giderek artan bir şekilde sunucularda bulunan NPU'lar, tipik yapay zeka görevleri için gelişmiş enerji verimliliği ve performans sunar. Genellikle sinir ağlarının belirli işlemlerini hızlandırma konusunda daha iyidirler, bu da daha düşük gecikme sürelerine ve daha az güç tüketimine yol açabilir. NPU'lardaki zorluk genellikle yazılım ekosistemindedir. Belirli kullanım durumları için optimize edilmiş olsalar da, modellerin taşınabilirliği ve NPU'nun tüm potansiyelini kullanan yazılım geliştirme, GPU'lara kıyasla daha karmaşık olabilir. TensorFlow veya PyTorch gibi mevcut çerçevelerle birlikte çalışabilirlik çok önemlidir.

Google tarafından geliştirilen Tensor İşleme Birimleri (TPU'lar) veya Cerebras gibi şirketlerin özel çipleri gibi ASIC'ler, belirli uygulama alanları için en yüksek performansı ve verimliliği sunar. Örneğin TPU'lar, matris işlemlerine göre optimize edilmiştir ve derin öğrenme modellerinin eğitiminde etkileyici sonuçlar elde eder. Çıkarım için kullanılan ASIC'ler son derece enerji verimli olabilir ve uç (edge) bilişim için mükemmeldir. Temel dezavantajı ise esneklik eksikliğidir. Yapay zeka algoritmaları veya donanım mimarisi değişirse, genellikle tamamen yeni bir ASIC geliştirilmesi gerekir ki bu da zaman ve maliyet açısından yoğun bir süreçtir. Belirli üreticilere ve onların tescilli mimarilerine olan bağımlılık da bir risk oluşturabilir.
Veri Merkezi Mimarisi Üzerindeki Etkileri
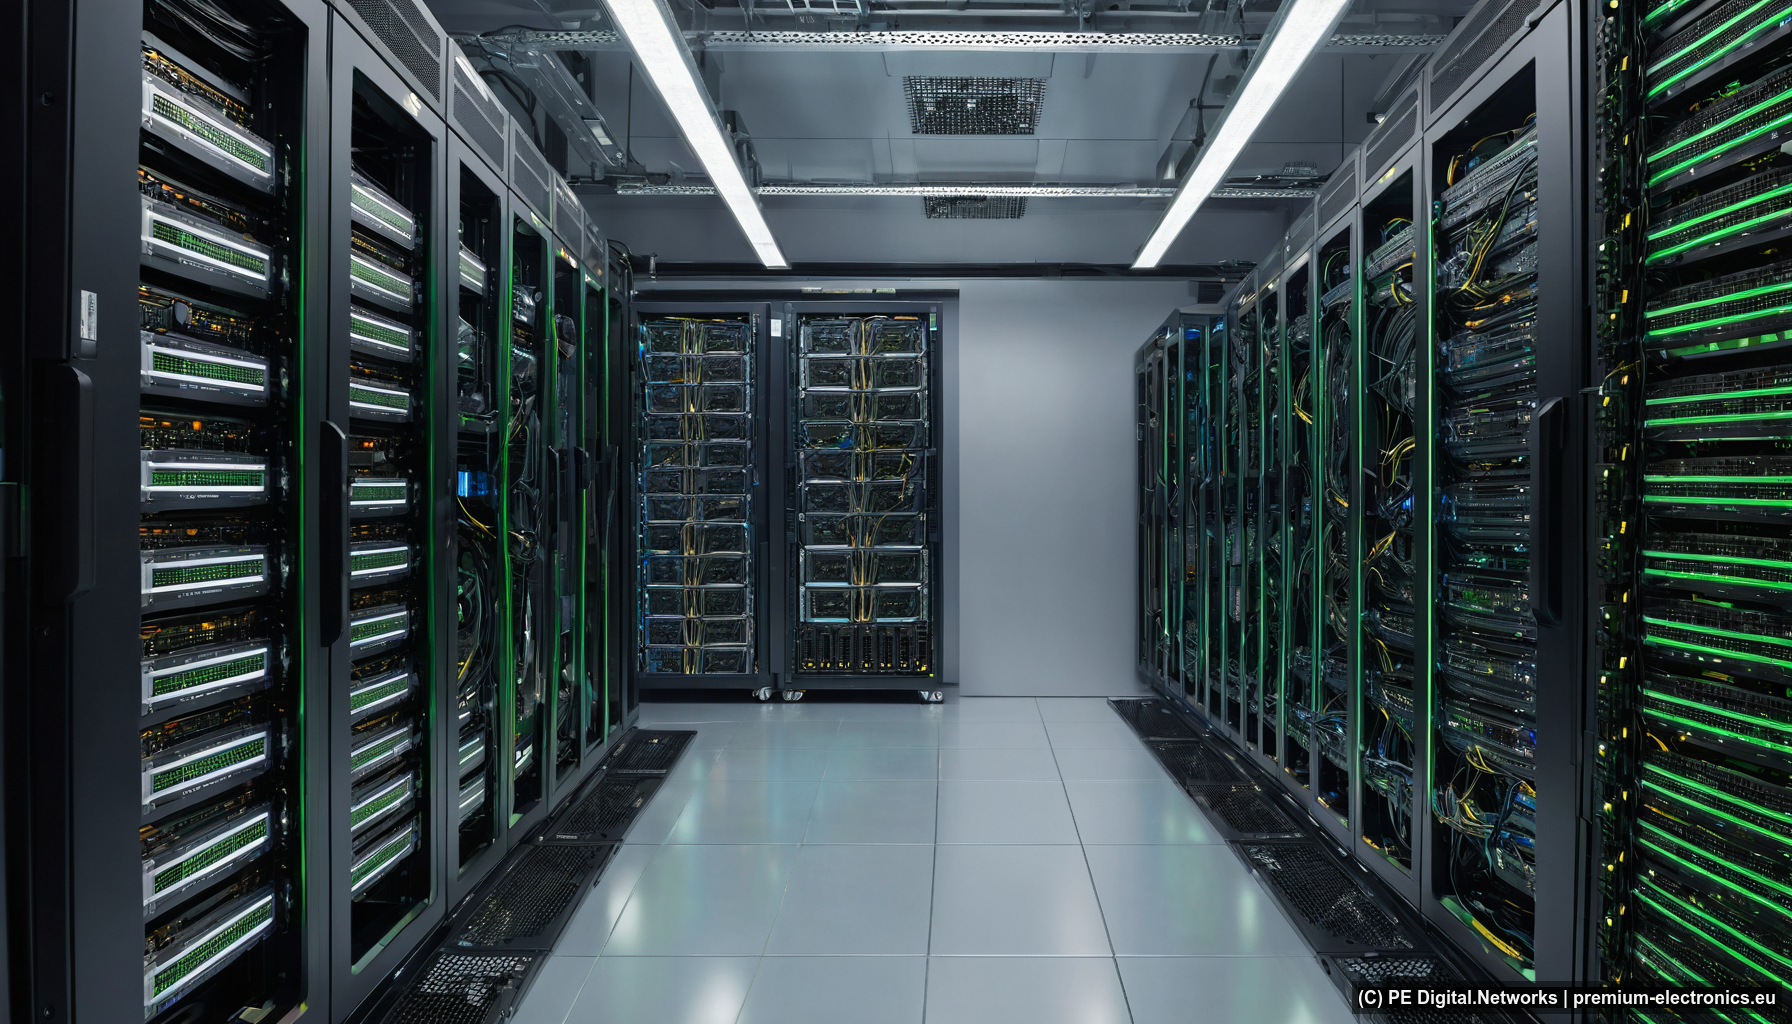
Uzmanlaşmış yapay zeka hızlandırıcılarının yaygınlaşması, veri merkezi mimarisi üzerinde derin etkilere sahiptir:
İşlemciler ve Sunucular: NPU'ların veya uzmanlaşmış yapay zeka hızlandırıcılarının doğrudan CPU'lara (heterojen işlemciler) veya sunucularda özel yardımcı işlemciler olarak entegre edilmesi giderek daha yaygın hale gelmektedir. Bu, geleneksel hesaplama birimleri ile yapay zeka hızlandırıcıları arasında daha sıkı bir bağlantı sağlayarak veri aktarımını ve gecikme sürelerini azaltır. Sunucu tasarımları, çeşitli hızlandırıcılarla esnek donanıma olanak tanımak için giderek daha modüler hale gelmektedir. Bu güçlü çipler önemli miktarda enerji tükettiği ve ısı yaydığı için soğutma ve güç kaynağı da kritik faktörler haline gelmektedir.
Ağ: Yapay zeka modellerinin eğitilmesi için üretilen ve hızlandırıcılar arasında değiştirilmesi gereken devasa miktardaki veri, son derece düşük gecikmeli yüksek hızlı ağlar gerektirir. Dağıtılmış eğitim ortamlarında kullanılan binlerce hızlandırıcı arasındaki iletişim bir darboğaz haline gelmektedir. Veri çıkışını en üst düzeye çıkarmak ve iletişim yükünü en aza indirmek için InfiniBand veya RDMA (Uzak Doğrudan Bellek Erişimi) özellikli Ethernet gibi özel ağ teknolojileri önem kazanmaktadır. Yapay zekaya özgü veri akışlarını tanıma ve önceliklendirme yeteneğine sahip akıllı ağ anahtarları da bir rol oynayabilir.
Yazılım: Yazılım katmanının yeni donanım ortamına uyum sağlaması gerekmektedir. TensorFlow, PyTorch ve ONNX gibi yapay zeka çerçeveleri, çeşitli hızlandırıcı mimarilerini desteklemeli ve modellerin bunlar üzerinde verimli bir şekilde yürütülmesini sağlamalıdır. Donanıma özgü optimizasyonlardan yararlanabilen derleyicilerin ve çalışma zamanı ortamlarının geliştirilmesi çok önemlidir. İş yüklerinin Kubernetes gibi heterojen hızlandırıcılar arasında düzenlenmesi daha karmaşık hale gelmektedir. Yapay zeka platformu sağlayıcıları, geliştiricilerin altta yatan donanımın ayrıntılarıyla ilgilenmek yerine model geliştirmeye odaklanmalarını sağlayacak bir soyutlama katmanı oluşturmak için çalışmaktadır. Veri hatlarının optimizasyonu ve yapay zeka iş yükleri için verimli veri depolama da kritiktir.
Karşılaştırma ve Değerlendirme
Peyzaj sürekli geliştiğinden ve birçok özel çözüm kamuya açık olmadığından, belirli ürünleri doğrudan karşılaştırmak zordur. Yine de güncel trendleri yansıtan genel kategorilere bakabiliriz:
| Ürün Kategorisi | Performans | Verimlilik | Uyumluluk | Geleceğe Uygunluk | Fiyat-Performans | |-----------------|-------------|-----------|-----------------|-------------------|-----------------| | Özel HPC GPU'ları (ör. NVIDIA H100) | 9 | 7 | 9 | 8 | 7 | | Uzmanlaşmış Yapay Zeka İşlemcileri (ör. Nöromorfik Çipler, bazı NPU'lar) | 8 | 9 | 6 | 7 | 8 | | Genel Amaçlı NPU'lar (ör. bulut sağlayıcılarındaki) | 8 | 8 | 7 | 8 | 8 | | Özelleştirilmiş ASIC'ler (ör. Google TPU) | 10 | 9 | 5 | 6 | 8 |
Teknoloji Pusulası Değerlendirmesi (belirli ürünler her zaman doğrudan karşılaştırılamadığı için genel bir yaklaşım olarak örneklenmiştir):
Özel HPC GPU'ları (ör. NVIDIA H100 muadili)
* Performans: 9/10 – Çok çeşitli yapay zeka iş yükleri, özellikle büyük modellerin eğitimi için olağanüstü performans sunar. Devasa paralellik, birçok görev için rakipsizdir. * Verimlilik: 7/10 – Performans yüksek olsa da, belirli görevler için uzmanlaşmış çözümlere kıyasla enerji tüketimi daha yüksek olabilir. Watt başına saf hesaplama gücü her zaman optimal değildir. * Uyumluluk: 9/10 – CUDA ekosistemi ve tüm yaygın yapay zeka çerçevelerindeki geniş destek, GPU'ları son derece uyumlu hale getirir. Çeşitli model mimarileri için yüksek esneklik sağlar. * Geleceğe Uygunluk: 8/10 – NVIDIA, GPU mimarisini ve yazılım ekosistemini geliştirmeye büyük yatırımlar yapmaktadır. Yeni nesiller, ortaya çıkan yapay zeka trendleri için sürekli iyileştirmeler ve destek sunar. * Fiyat-Performans: 7/10 – Yüksek satın alma maliyetleri vardır, ancak çok yönlülük ve geniş bulunabilirlik bunu birçok kullanım durumu için haklı çıkarır. Ölçeklenebilirlik bir avantajdır.

Uzmanlaşmış Yapay Zeka İşlemcileri (ör. Nöromorfik çipler, start-up'ların özel yapay zeka çipleri)
* Performans: 8/10 – Optimize edildikleri belirli yapay zeka görev alanları için çok yüksek performans elde edebilirler. Genellikle çıkarım ve uzmanlaşmış mimariler için iyidirler. * Verimlilik: 9/10 – Güçlü yanları budur. Bu işlemciler genellikle watt başına maksimum performans sağlamak üzere tasarlanmıştır, bu da onları enerji bilincine sahip uygulamalar için ideal kılar. * Uyumluluk: 6/10 – Genellikle tescilli mimariler veya sınırlı bir yazılım ekosistemi söz konusudur. Mevcut çerçevelere entegrasyon zorlayıcı olabilir ve genellikle özel kütüphaneler veya ayarlamalar gerektirir. * Geleceğe Uygunluk: 7/10 – Geliştiriciye ve belirli kullanım durumuna bağlıdır. Bazı niş çözümler hızla eskiyebilirken, geleceğe yönelik mimarilere dayanan diğerleri uzun süre geçerli kalabilir. * Fiyat-Performans: 8/10 – Özellikle belirli görev, işlemcinin güçlü yönlerine tam olarak uygun olduğunda çok rekabetçi olabilir. Daha düşük güç tüketimi işletme maliyetlerini düşürebilir.
Genel Amaçlı NPU'lar (ör. bulut platformlarına entegre edilmiş veya özel kartlar olarak)
* Performans: 8/10 – Çok çeşitli yapay zeka iş yükleri için performans ve verimlilik arasında iyi bir denge sunar. Yapay zeka görevleri için genellikle CPU'lara göre bir gelişmedir. * Verimlilik: 8/10 – Yapay zeka görevleri için salt CPU'lardan önemli ölçüde daha enerji verimlidir ve belirli çıkarım iş yükleri için GPU'larla da genellikle rekabet edebilir. * Uyumluluk: 7/10 – Yaygın çerçeveler tarafından desteklenir, ancak optimum kullanım için özelleştirilmiş kütüphaneler veya ilgili NPU mimarisine yönelik özel optimizasyonlar gerekebilir. * Geleceğe Uygunluk: 8/10 – Birçok büyük teknoloji şirketi NPU'lara yatırım yaptığı için, gelecekteki ürünlere sürekli geliştirme ve entegrasyon muhtemeldir. * Fiyat-Performans: 8/10 – Özellikle esnek bir şekilde devreye alınabildikleri bulut ortamlarında, genellikle cazip bir fiyat-performans oranı sunarlar.
Özelleştirilmiş ASIC'ler (ör. Google TPU)
* Performans: 10/10 – Geliştirildikleri belirli görevler için ASIC'ler kesinlikle en yüksek performansı sunar. Bu, özellikle büyük matris işlemleri için geçerlidir. * Verimlilik: 9/10 – Çipin her parçası bu amaç için optimize edildiğinden, belirli görevleri için watt başına performans açısından neredeyse rakipsizdir. * Uyumluluk: 5/10 – Tescilli mimariler genellikle üreticiye ve yazılım ekosistemine güçlü bir bağımlılık gerektirir. Modellerin taşınabilirliği ve genel ortamlarda kullanımı zor olabilir. * Geleceğe Uygunluk: 6/10 – Esneklik en büyük zayıflıktır. Yapay zeka algoritmaları ciddi şekilde değişirse, bir ASIC hızla eskiyebilir. Bir ASIC'e yapılan yatırım, altta yatan teknolojinin ömrüne bağlıdır. * Fiyat-Performans: 8/10 – İlk geliştirme maliyetleri son derece yüksektir, ancak belirli bir ASIC'e dayanan ve büyük miktarlarda üretilen uygulamalar için performans ve verimlilik, mükemmel bir fiyat-performans oranına yol açabilir.
Sonuç ve Senaryolar
Yapay zeka hızlandırıcılarının özel GPU'lardan uzmanlaşmış NPU'lara ve ASIC'lere evrimi bir değişim değil, bir çeşitlendirmedir. Geleceğin veri merkezleri, farklı yapay zeka görevleri için optimize edilmiş heterojen bir işlemci ortamına ev sahipliği yapacaktır. GPU'lar esnek genel amaçlı hızlandırıcılar olarak rollerini korurken, NPU'lar ve ASIC'ler belirli, performans açısından kritik veya enerji verimliliği odaklı iş yükleri için kullanılacaktır.
Gelecek için senaryolar:
- Hibrit Veri Merkezleri: Büyük ölçekli veri merkezleri; esnek eğitim ve araştırma için GPU'ların, ölçeklenebilir çıkarım için NPU'ların ve yüksek oranda optimize edilmiş, tekrarlayan görevler için uzmanlaşmış ASIC'lerin bir karışımını içerecektir.
- Uç Yapay Zeka (Edge AI): Zekanın uç noktalara taşınmasıyla birlikte, enerji verimli NPU'lar ve gömülü sistemler ile IoT cihazlarına yönelik uzmanlaşmış yapay zeka çipleri giderek daha önemli bir rol oynayacaktır.
- Bulut tabanlı Yapay Zeka Orkestrasyonu: Bulut sağlayıcıları, yazılım katmanının donanım karmaşıklığını gizlemesi ve en uygun kaynağın sorunsuz bir şekilde seçilmesine olanak tanımasıyla, hizmet olarak farklı hızlandırıcı türleri sunmaya devam edecektir.
- Çip Mimarisindeki İlerlemeler: Nöromorfik çipler ve diğer yeni yaklaşımlar üzerindeki araştırmalar, yapay zeka hesaplamaları için potansiyel olarak daha enerji verimli ve güçlü yeni paradigmalar açacaktır.
Veri merkezi mimarisinin bu gelişen donanım ortamına uyarlanması, yapay zeka inovasyonunun zirvesinde kalmak isteyen şirketler için çok önemlidir. Her görev için doğru hızlandırıcının seçimi, yazılım altyapısının optimizasyonu ve ölçeklenebilir ağların tasarlanması, bu dinamik alanda başarının temel bileşenleridir.